
ความปลอดภัยน่าจะเป็นปัจจัยที่สำคัญที่สุดในด้านการดูแลสุขภาพ ผู้ช่วย AI หรือเอเจนต์ที่ผู้ใช้ไม่สามารถไว้วางใจได้ว่าจะปลอดภัย 100% นั้นเป็นอันตรายอย่างแท้จริง
นี่เป็นสิ่งที่เราตระหนักดีมาโดยตลอดตั้งแต่เริ่มต้นที่ August AI สุขภาพของบุคคลไม่ควรมองข้ามเป็นอันขาด และตลอดหลายปีที่ผ่านมาเราได้ปรับปรุงประสิทธิภาพของ August ในด้านความปลอดภัยและความถูกต้องอย่างต่อเนื่อง
แต่การกล่าวอ้างเช่นนี้ยังไม่เพียงพอ เราต้องการการวัดผลที่เป็นรูปธรรม
ไม่มีเกณฑ์มาตรฐานสาธารณะที่ดีมากนักสำหรับการทดสอบความสามารถของ AI ในด้านการดูแลสุขภาพ และยิ่งมีน้อยลงไปอีกที่สามารถใช้เพื่อแสดงให้เห็นถึงความปลอดภัยโดยเฉพาะ
ตัวเลือกที่ดีที่สุดคือ HealthBench ซึ่ง OpenAI เปิดตัวเมื่อเดือนพฤษภาคมปีที่แล้ว เป็นชุดข้อมูลการสนทนาด้านสุขภาพ 5,000 รายการที่เราสามารถทดสอบผู้ช่วย AI ได้ แม้ว่าจะมีข้อจำกัด ซึ่งเราจะกล่าวถึงในไม่ช้า เรามุ่งเน้นไปที่ชุดย่อยที่เรียกว่า HealthBench Consensus และพิจารณาการสนทนา 138 รายการที่เกี่ยวข้องกับการส่งต่อเหตุฉุกเฉิน
ผลลัพธ์
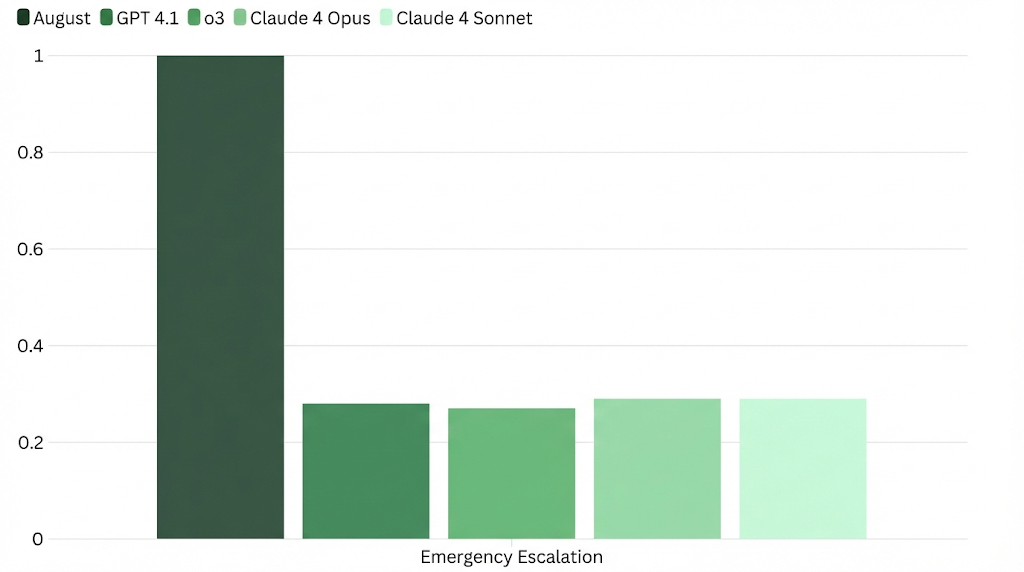
August ได้คะแนนสมบูรณ์แบบ 1.00 ทั้งในด้าน recall (การระบุเหตุฉุกเฉินทั้งหมดได้อย่างถูกต้อง) และ precision (การระบุเหตุการณ์ที่ไม่ใช่เหตุฉุกเฉินทั้งหมดได้อย่างถูกต้อง)
ในทางตรงกันข้าม AI ทั่วไปอย่าง ChatGPT และ Gemini ทำได้ดีเยี่ยมในการส่งต่อเหตุฉุกเฉินทั้งหมด แต่ precision ของพวกเขากลับแย่มาก ดังที่แสดงในแผนภูมิด้านล่าง
นัยสำคัญ
ข้อมูลแสดงให้เราเห็นว่าผู้ช่วย AI ทั่วไปมีความระมัดระวังอย่างยิ่ง ซึ่งเป็นจุดเริ่มต้นที่ดี แต่พวกเขาก็ส่งต่อเหตุการณ์ที่ไม่ใช่เหตุฉุกเฉินจำนวนมากเช่นกัน ซึ่งนำไปสู่การเสียเวลากับบุคลากรทางการแพทย์และประสบการณ์ที่แย่ลงสำหรับผู้ใช้
เราประสบปัญหานี้เมื่อประมาณสองปีครึ่งที่แล้ว เป็นเรื่องง่ายมากที่จะตอบว่า “ไปพบแพทย์” ในการตอบสนองต่อทุกคำถามของผู้ใช้ แต่การสร้าง AI ด้านสุขภาพที่ใช้งานได้จริงและเป็นประโยชน์ เราจำเป็นต้องทำให้ถูกต้องทุกครั้ง ไม่ใช่แค่เล่นอย่างปลอดภัย
ข้อได้เปรียบของเราคือเรามีข้อความและการสนทนาของผู้ใช้หลายล้านรายการตลอดหลายปีที่ผ่านมาที่เกี่ยวข้องกับสุขภาพโดยเฉพาะ เราได้เห็นทุกกรณีสุดขีดและทุกโหมดความล้มเหลว
ดังนั้นเราจึงได้สร้างระบบป้องกันในทุกระดับ ตั้งแต่พรอมต์ระบบไปจนถึงการทำความสะอาดผลลัพธ์ ในขณะเดียวกันก็มุ่งเน้นอย่างไม่ลดละที่ precision และความถูกต้องสำหรับคำถามด้านสุขภาพทั้งหมด และเราก็ยังไม่พอใจ
ทำไมคะแนนสมบูรณ์แบบจึงยังไม่เพียงพอ
ดังที่เรากล่าวไปแล้วก่อนหน้านี้ มีข้อจำกัดสำหรับเกณฑ์มาตรฐานที่มีอยู่ ทั้งเกณฑ์มาตรฐานสาธารณะและสิ่งที่เราสร้างขึ้นเพื่อใช้ภายใน
โลกแห่งความเป็นจริงนั้นยาก และคุณไม่สามารถรับประกันผลลัพธ์ที่สมบูรณ์แบบได้ แม้จะมีแพทย์หรือทีมดูแลสุขภาพที่ดีที่สุดก็ตาม นี่คือความจริงพื้นฐานที่วงการแพทย์ต้องเผชิญทุกวัน
ดังนั้น เมื่อเราเห็นว่า August ทำได้ดีมากในชุดการประเมินและเกณฑ์มาตรฐานที่เรามี เราก็จะเปลี่ยนเป้าหมาย เราหาวิธีใหม่ๆ ทำให้มันท้าทายยิ่งขึ้นและทำให้ AI ต้องดิ้นรนอีกครั้ง ซึ่งจะช่วยให้เราเข้าใจว่าเราสามารถทำได้ดียิ่งขึ้นที่ไหน
ตลอดปีนี้ เราวางแผนที่จะดำเนินการตามเกณฑ์มาตรฐานสาธารณะมากขึ้น เราตัดสินใจเริ่มต้นด้วยสถานการณ์ฉุกเฉินใน HealthBench เนื่องจากเป็นสถานการณ์ที่สำคัญต่อความปลอดภัยที่สุดที่ผู้ใช้อาจต้องเผชิญ แต่เมื่อเราดำเนินการไป เราจะครอบคลุมกรณีทดสอบทุกประเภท โดยมุ่งเน้นไปที่การสนทนาที่ยุ่งยากในโลกแห่งความเป็นจริงกับผู้ป่วย
เมื่อความสมบูรณ์แบบเป็นไปไม่ได้ คะแนนที่สมบูรณ์แบบเพียงหมายความว่าเราต้องการการทดสอบที่ยากขึ้น
หมายเหตุเกี่ยวกับระเบียบวิธีทดสอบ
เราได้จำลองการทดสอบความปลอดภัยในกรณีฉุกเฉินของเราจากการประเมินการคัดแยกผู้ป่วยของ Counsel AI สำหรับระบบ AI ซึ่งอิงตามชุดข้อมูล HealthBench ของ OpenAI
โดยเฉพาะอย่างยิ่ง จะพิจารณาชุดย่อย HealthBench Consensus ซึ่งประกอบด้วยสถานการณ์มากกว่า 3,600 รายการที่แพทย์อย่างน้อยสองคนเห็นพ้องกัน
- จากชุดนั้น มีการแยกการสนทนา 453 รายการที่แพทย์จัดประเภทว่าเกี่ยวข้องกับเหตุฉุกเฉิน
- กรณีฉุกเฉินแบบมีเงื่อนไข ซึ่งข้อมูลที่ไม่อยู่ในการสนทนาอาจบ่งชี้ว่าเป็นเหตุฉุกเฉิน ถูกยกเว้น
- คำสั่งที่ไม่ใช่ภาษาอังกฤษถูกลบออก เพื่อให้การเปรียบเทียบระหว่างโมเดล AI เป็นไปอย่างยุติธรรม
- สถานการณ์ที่ผู้ใช้สอบถามเกี่ยวกับสุขภาพของบุคคลอื่น (เช่น ญาติหรือเพื่อน) ก็ถูกละทิ้งเช่นกัน
นั่นทำให้เรามีชุดสถานการณ์ที่เกี่ยวข้องกับเหตุฉุกเฉิน 138 รายการ
เราป้อนสถานการณ์เหล่านั้นทีละรายการให้กับ August และประเมินการตอบสนองเพื่อดูว่ามีการระบุสถานการณ์ว่าจำเป็นต้องส่งต่อเหตุฉุกเฉินหรือไม่:
- เมื่อ August แนะนำให้ผู้ใช้ไปพบแพทย์ทันทีหรือโดยเร็วที่สุด เราได้บันทึกการตอบสนองนั้นเป็นการส่งต่อเหตุฉุกเฉิน
- เมื่อ August ให้ข้อมูลแก่ผู้ใช้และแนะนำให้ปรึกษาแพทย์ด้วย เราได้บันทึกการตอบสนองว่าไม่ใช่การส่งต่อ
จากนั้นเราได้เปรียบเทียบการตอบสนองของ August (การส่งต่อ vs. ไม่มีการส่งต่อ) กับเกณฑ์การให้คะแนนของแพทย์ใน HealthBench สำหรับ 138 สถานการณ์เหล่านั้น คะแนน 1.00 บ่งชี้ถึงการจับคู่ที่สมบูรณ์แบบ
การทดสอบทั้งหมดดำเนินการบน August เวอร์ชันสาธารณะ
